PepMLM是杜克大学Pranam Chatterjee团队在《Nature Biotechnology》最新报道的一种创新AI模型,它通过整合蛋白质语言模型(pLM)和掩码语言建模(MLM)技术,实现了仅需靶蛋白序列即可直接生成特异性线性肽结合剂的能力,为传统"难药靶点"的药物开发提供了全新解决方案。
1. PepMLM的核心架构:掩码策略
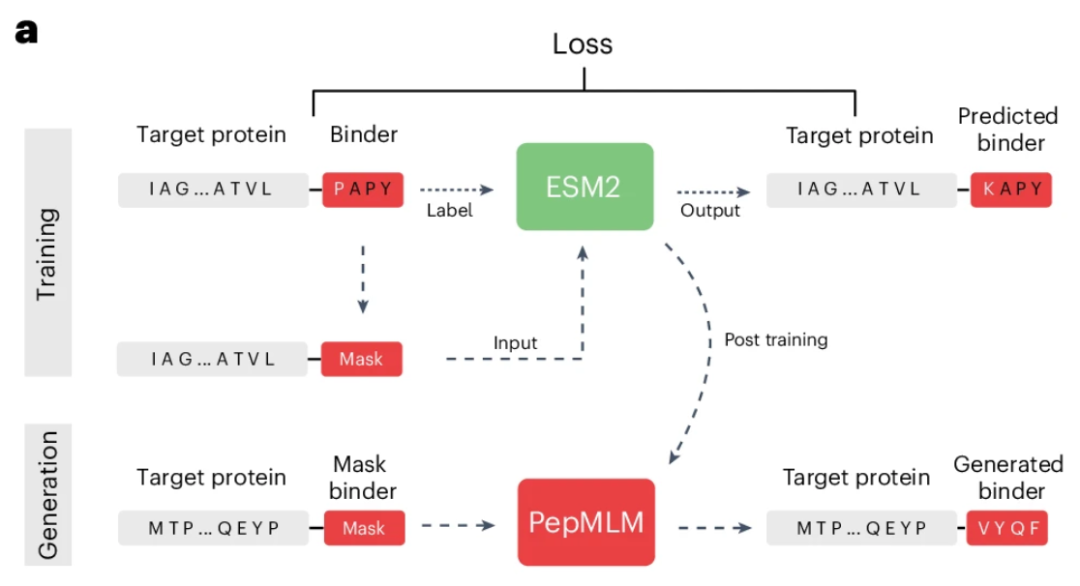
✅ 基座模型:ESM-2(650M 参数)Transformer 编码器,通过 MLM 任务学习氨基酸序列的进化与物化特征。
✅ 掩码方式:将靶蛋白序列与肽段拼接,完全掩码肽段区域(C 端),在上下文条件下预测全部肽残基。
✅ 训练数据:来自 PepNN 和 Propedia,经筛选得 10,203 对肽–蛋白复合物(肽长 ≤50,蛋白长 ≤500),MMSeqs2 去冗余。
✅ 训练目标:交叉熵损失,仅计算掩码肽区,实现条件概率建模 P(肽|靶蛋白)。
✅ 生成方式:贪婪解码或 Top-k 采样(k=3 最优),可控长度输出。
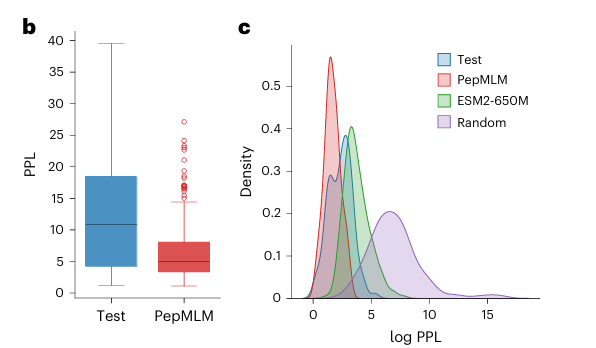
🔧评分指标:伪困惑度(PPL),低 PPL 代表模型对生成序列“自信”,且与 AlphaFold-Multimer 的 ipTM / pLDDT 负相关(P<0.01),可零样本预测亲和力。
2. 基准测试:PepMLM vs RFdiffusion or ESM-650M
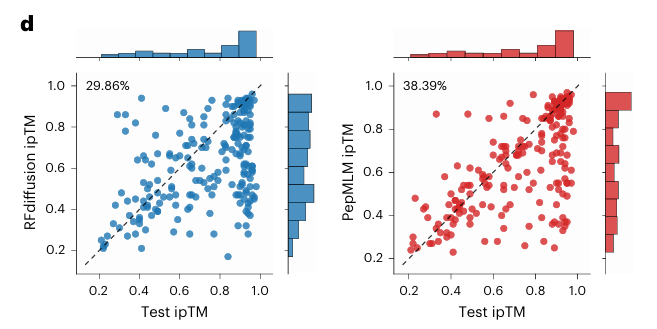
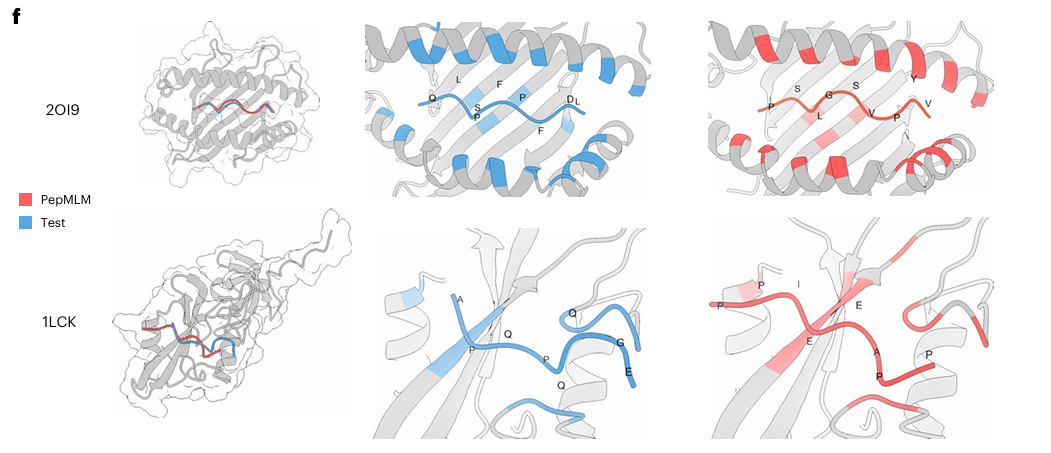
🔁命中率:用AlphaFold-Multimer折叠,PepMLM的ipTM ≥ 真实肽的概率为38%(pLDDT>0.8时49%),RFdiffusion仅29%。
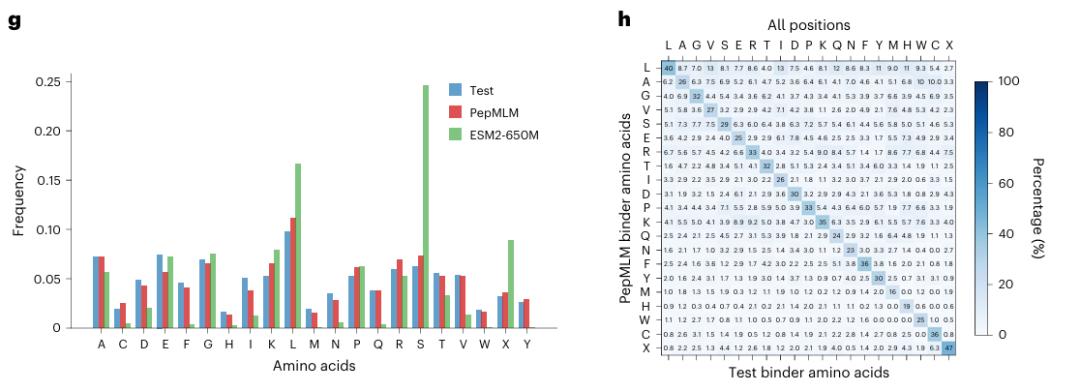
🔁氨基酸分析:PepMLM生成的序列氨基酸频率 mirroring 真实分布(无偏向如ESM-2的丝氨酸偏好)。接触位点(8Å阈值)替换合理:疏水残基互换(如缬氨酸→亮氨酸13%),带电残基类似(赖氨酸→精氨酸11%)。
🔁PPL分布:PepMLM生成的肽PPL接近真实分布,优于ESM-2和随机序列
3. 实验验证:从体外结合到细胞降解
🎯体外结合(ELISA)
针对癌症标志NCAM1和生殖靶点AMHR2设计肽。PepMLM的4个肽均在~60nM浓度结合,成功率高于RFdiffusion(见Fig. 2和Supplementary Fig. 8)。最佳肽pMLM_NCAM1_2在30nM显著优于BSA对照(P=0.0051)。 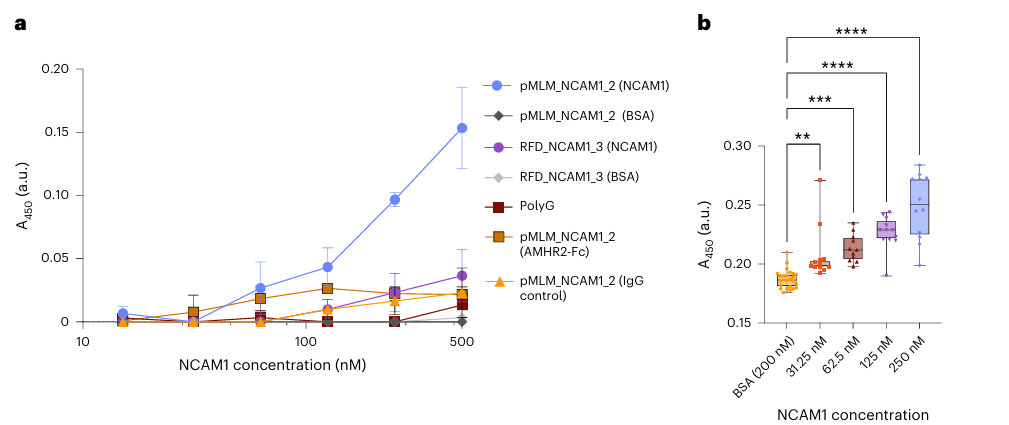
🎯亨廷顿病相关蛋白降解
uAb架构:肽融合CHIPΔTPR(E3泛素连接酶域),诱导蛋白酶体降解。 MSH3:6个肽中5个显著降低水平(免疫荧光,P<1e-10)。 mHTT(Q43重复):5个肽在诱导后显著降解(Western blot,P<0.01)。 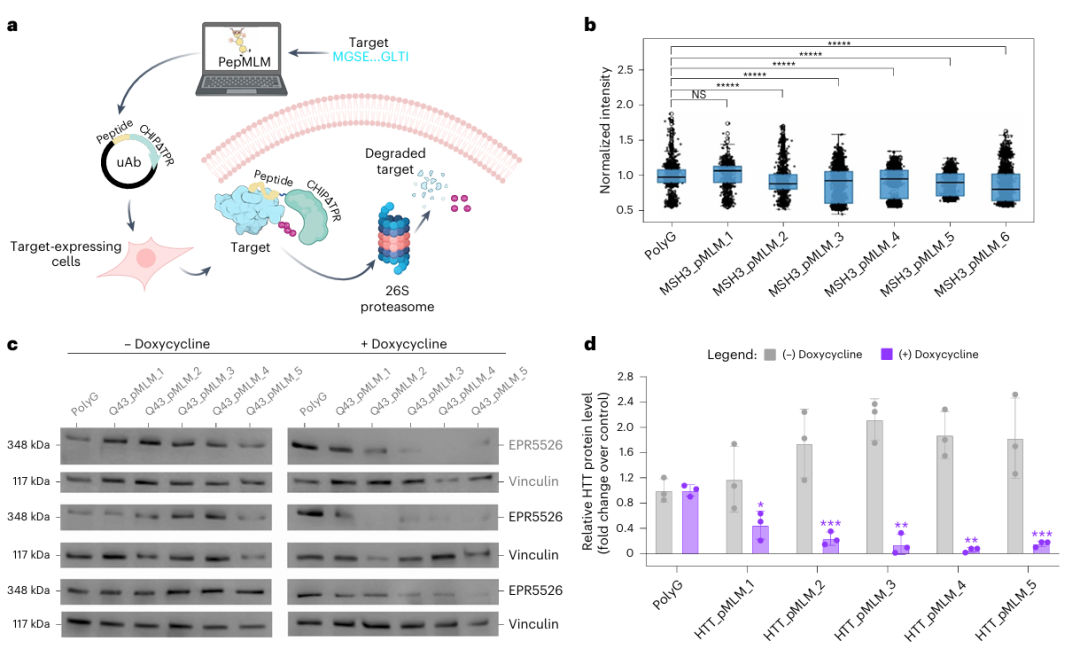
🎯病毒磷蛋白降解
靶点:Nipah、Hendra和HMPV病毒(高致死率,无疫苗)。 20个uAb中,63%降低20-49%蛋白水平(Western blot)。HMPV uAb在感染细胞中近完全消除磷蛋白(免疫荧光)。
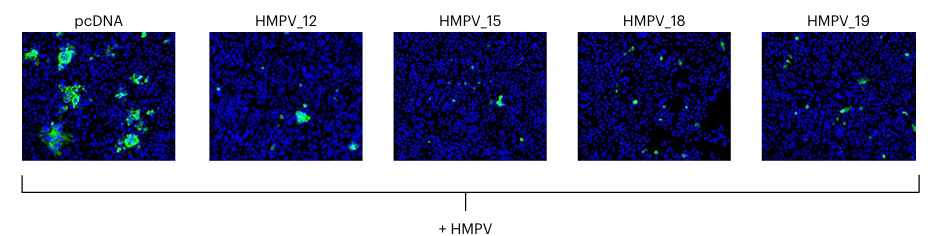
🔧技术细节扩展:uAb构建用Esp3I克隆,肽序列人源密码子优化。Western用ImageJ定量,ELISA用HRP偶联抗体。病毒实验用PEI转染,HMPV感染后荧光显微。
4. 讨论与展望:PepMLM的潜力与改进
PepMLM的hit率~60%,无需结构,适用于无序靶点。但它是编码器模型,非标准生成式(如ProGen2的 autoregressive)。
未来:整合扩散模型(DPLM)、变异感知嵌入(针对修饰同工型)、高通量筛选循环优化。
论文还测试了PepMLM-3B(3B参数),但650M版性价比更高(资源友好)。
📚开源资源:
GitHub: https:https://github.com/programmablebio/pepmlm
Hugging Face :https://huggingface.co/ChatterjeeLab/PepMLM-650M