近年来,深度学习方法如 RFdiffusion1(RFD1)和 RFdiffusion2(RFD2)显著推动了蛋白质设计的进展,能够直接生成蛋白质单体、复合物以及结合蛋白。然而,这些方法大多仍局限于“氨基酸残基”级别的表示,难以精确处理小分子、核酸(如 DNA)等非蛋白成分的相互作用。
针对这一瓶颈,Baker 团队提出了关键解决方案:构建一个真正的“全原子”模型。RFdiffusion3(RFD3)在此基础上应运而生。该模型基于扩散模型(diffusion model),直接处理包括主链和侧链在内的所有原子,并支持蛋白质与小分子、核酸的协同生成。其参数量仅为1.68亿(比AlphaFold3的扩散模块减少一半),计算成本却大幅降低至原来RFdiffusion的十分之一。
论文一经发布,立刻在科研社区引发热烈反响。第一作者 Jasper Butcher 在社交媒体上表示:“通过团队协作,我们成功构建了一个能够设计任意生物分子相互作用的统一模型!”另一位作者 Rohith Krishna 也发文称:“RFD3 已在实验室中开启全新的设计方向,代码即将开源!”
🌟 RFdiffusion3 是什么?
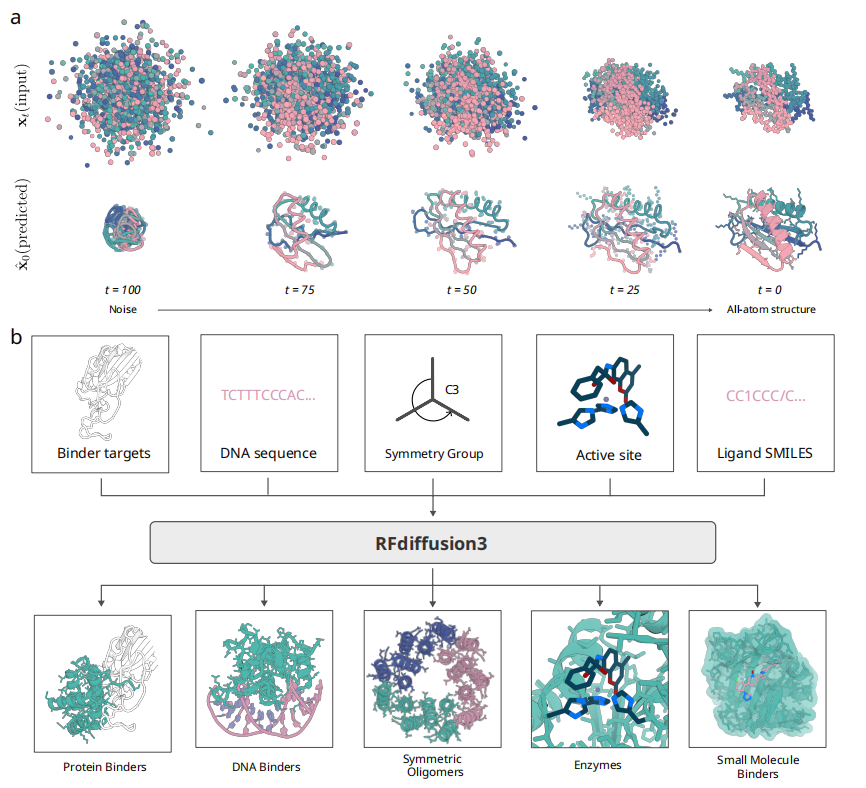
与前代方法 RFdiffusion1/2 主要局限于“氨基酸残基”层面的扩散不同,RFD3 实现了更精细的全原子尺度扩散。它不仅能够同时建模蛋白质的主链和侧链原子,还能与 DNA、RNA、小分子等非蛋白组分协同生成,实现对复合物结构的精确设计。
也就是说,RFD3 让研究人员能够在原子级别上灵活“组装”生物大分子,像搭积木一样精确构建蛋白质与其他功能分子之间的相互作用界面。
🔑RFD3 的核心架构
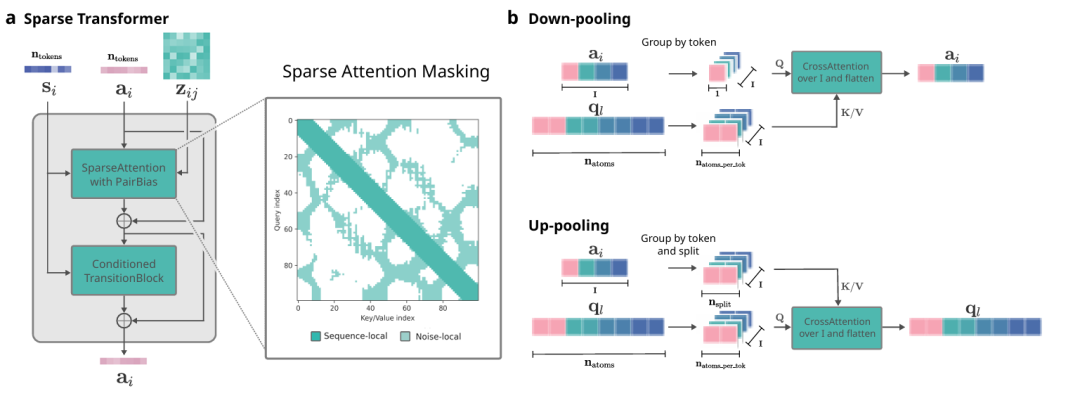
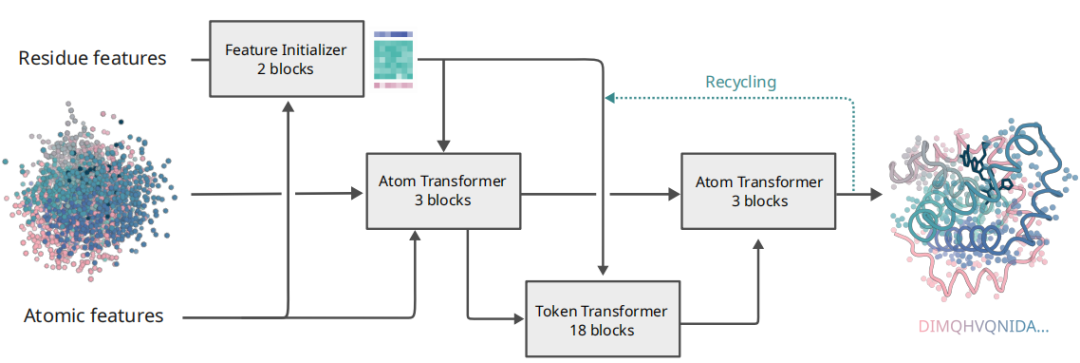
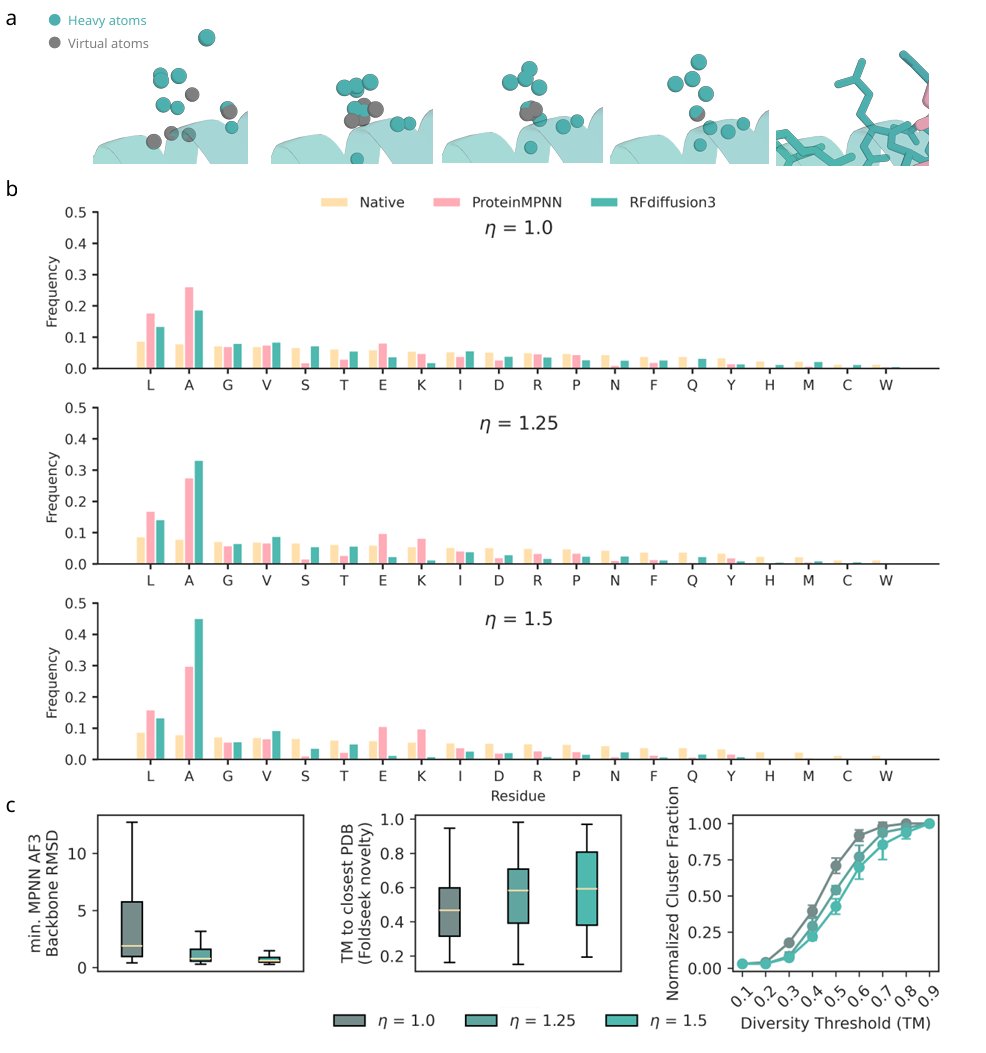
RFD3 的核心架构围绕“原子级扩散”与“多模态条件化”两大突破展开。该模型基于专门为生物分子建模设计的 AtomWorks 框架,将每个氨基酸表示为4个主链原子和最多10个侧链原子(对小侧链使用虚拟原子填充以保证统一表示)。其主干是一个基于 Transformer 的 U-Net 结构,主要分为三个部分:
稀疏 Transformer 模块:通过几何邻近性约束原子间的交互,仅允许空间邻近的原子交换信息,既捕获局部结构又防止过拟合;
下采样模块:负责编码带噪声的原子坐标和残基特征;
上采样模块:利用交叉注意力机制融合原子级别和残基级别的特征,最终预测去噪后的坐标更新。
与 AlphaFold3 不同,RFD3 采用轻量级的 Pairformer(仅2层)来处理条件信息,并省略了计算密集的三角注意力机制,大幅提升了生成速度。
模型支持丰富且灵活的条件控制方式,包括:
原子级约束:可指定催化残基、氢键供体/受体等化学功能,借助分类器引导策略显著提升氢键形成概率(10–23%);
溶剂暴露程度:控制配体或蛋白界面的埋藏程度;
中心质点约束:指定蛋白质相对于结合靶点的空间质心;
对称性控制:支持生成二聚体、寡聚体等对称组装体;
联合采样:实现蛋白质与 DNA、RNA、小分子等的同步生成与构象优化。
训练策略上,RFD3 采用分层预训练加微调的方法:首先在 PDB 真实复合物结构(数据截至2024年12月)及高质量 AlphaFold2 预测结构上进行预训练,随后针对蛋白–DNA 相互作用及蛋白–蛋白复合物等进行任务特定微调。
RFD3 在计算基准测试(In Silico Benchmarks)中展现出卓越性能,使用 AlphaFold3/Chai 进行评估,涵盖序列-结构一致性(如 RMSD、pTM、PAE 等指标)。
无条件生成:生成的100–250个残基蛋白质显示出高多样性(96个设计中形成41个聚类,TM-score阈值为0.5);序列组成中丙氨酸占比较高(因模型偏好紧凑折叠);98%的设计经ProteinMPNN重新序列优化后,AlphaFold3预测的结构与原始设计间RMSD小于1.5 Å。
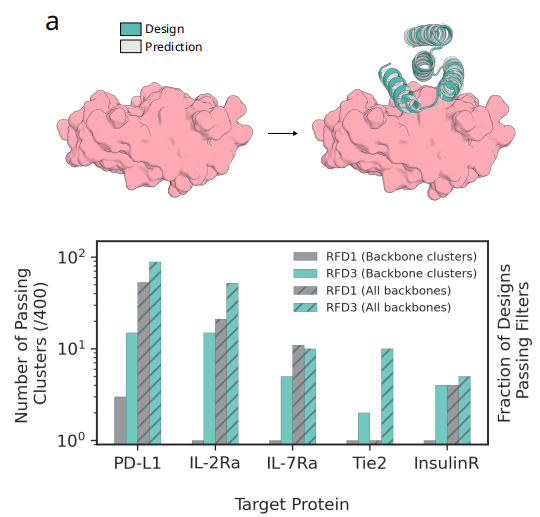
蛋白-蛋白结合设计:针对5个治疗相关靶点(PD-L1、InsulinR、IL-7Ra、Tie2、IL-2Ra)生成400个设计,支持原子级别“热点”残基指定。RFD3在4/5的靶点上表现优于RFdiffusion1(平均成功聚类数8.2 vs. 1.4,TM-score ≥ 0.6),并生成更多样化的结合界面。
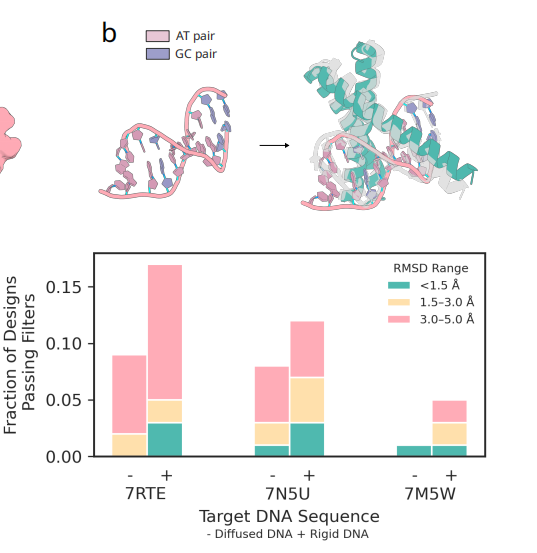
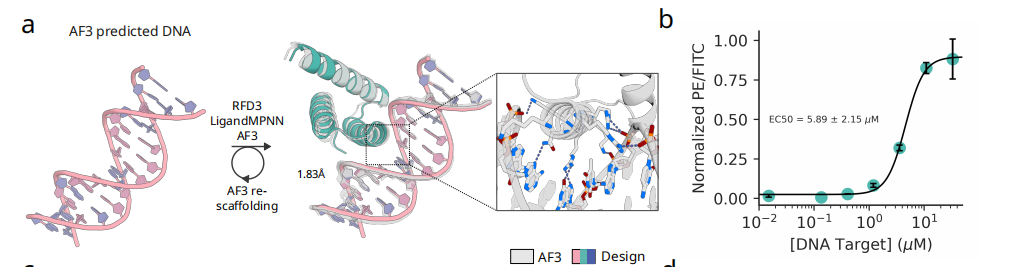
DNA结合蛋白设计:实现了蛋白质与DNA的联合生成(DNA结构仅从序列推断)。针对3个训练集未包含的DNA序列,单体设计成功率8.67%、二聚体为6.67%(DNA对齐RMSD < 5 Å);不预先固定DNA结构可提高构象多样性。固定界面后使用LigandMPNN优化序列,成功率分别为6.5%和5.5%。
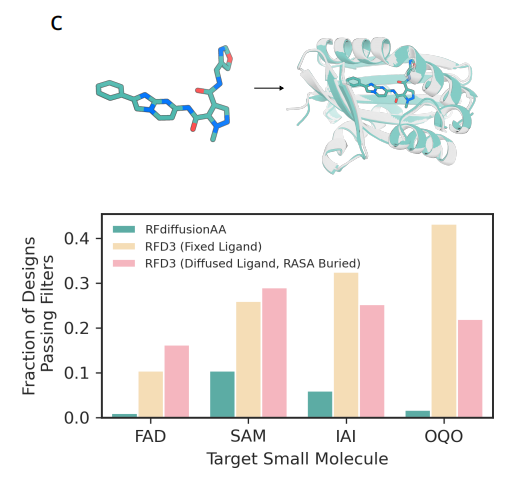
小分子结合蛋白设计:在4种配体(FAD、SAM、IAI、OQO)的基准测试中,RFD3优于RFdiffusionAA,成功标准为蛋白RMSD < 1.5 Å、配体RMSD < 5 Å、最小PAE < 1.5、ipTM > 0.8;联合采样能够生成更新颖、能量更低的复合物结构。
酶活性位点支架化设计:在原子基序酶(AME)基准测试(涵盖41个活性位点)中,RFD3在90%的案例中优于RFD2;对于超过4个残基的“活性岛”,成功率达15%(RFD2为4%);支持对称性支架设计(所有测试案例均成功生成双亚基活性位点,包括一个7残基岛案例;图3d、S5、S6)。
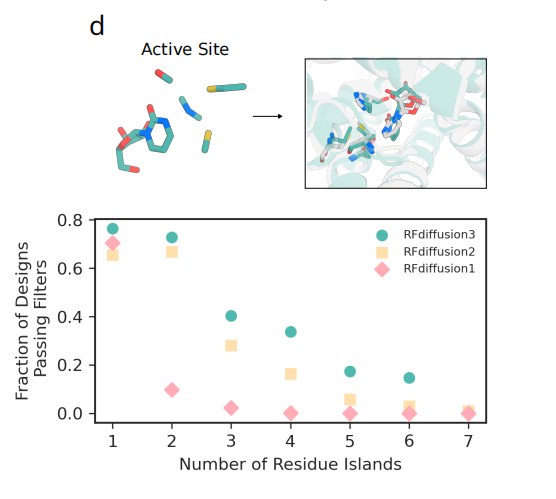
生成的设计在结构上兼具多样性和新颖性(与PDB现有结构相似度低),经ProteinMPNN重新序列设计后,约70%的设计保留了原有的相互作用界面。
🔥实验验证
RFD3在计算层面的优势成功转化为体外实验验证。研究团队重点针对DNA结合和酶设计两类高难度任务进行了实验测试。
DNA结合蛋白:采用两阶段设计流程:1)针对一段随机DNA序列(CGAGAACATAGTCG,其结构由AF3预测)生成结合蛋白;2)固定关键接触残基,重新采样优化主链构象。合成了5个设计基因,通过酵母表面展示及流式细胞术测量结合亲和力,其中1个设计(DBRFD3)表现出结合活性,EC₅₀ = 5.89 ± 2.15 µM(三次独立实验,四参数logistic拟合)。结构分析表明其通过大沟极性相互作用实现结合。
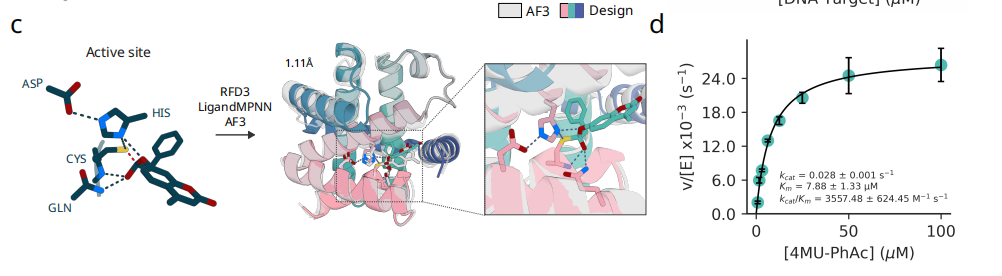
半胱氨酸水解酶设计:以Ulp-1(PDB: 1EUU)中的最小催化基序(Cys-His-Asp三联体、Gln及底物四面体中间体)为条件,设计用于水解酯底物(4-甲基伞形酮苯乙酸酯)的酶。在筛选的190个设计中,35个显示出多周转催化活性;其中最优设计的Kcat/Km达到3557 M⁻¹s⁻¹,性能超过此前报道的人工酶设计
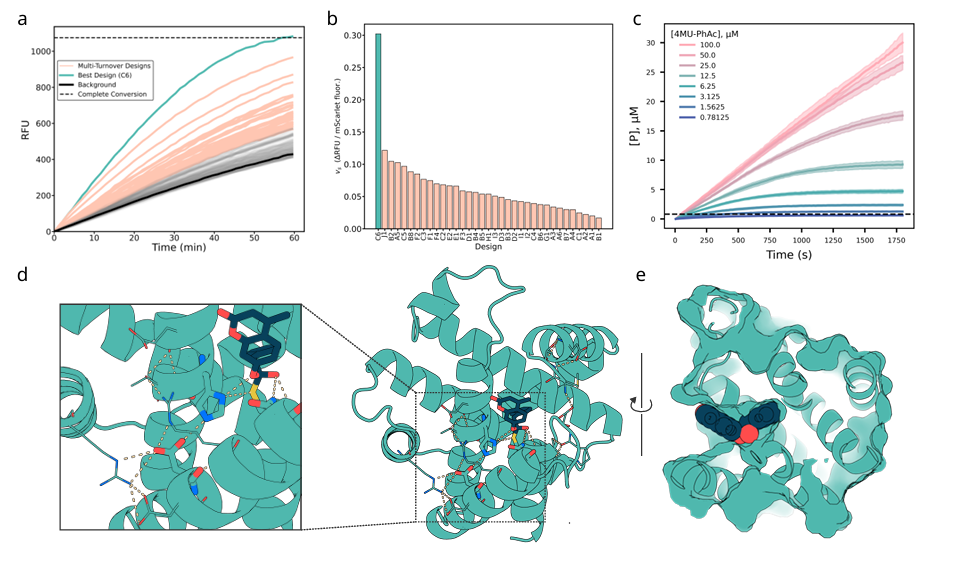
实验结果表明,RFD3的原子级条件控制显著提高了设计精度;同时,固定关键相互作用残基并未对蛋白质整体折叠产生显著负面影响。
👍结语
论文中指出,其实现基于 AtomWorks 框架(源码位于 GitHub: RosettaCommons/atomworks)。虽然 RFD3 的具体代码库尚未发布,但作者已公开确认 “Code coming soon!”,预示其开源在即。与此同时,在 ModelForge 模型仓库(GitHub: RosettaCommons/modelforge)中,已经整合了与之紧密相关的模型。
RFD3 不只是工具升级,更是蛋白设计范式的转变。它让原子精确功能(如催化、传感)触手可及,适用于治疗(如抗体、酶)和合成生物学。局限?依赖后序列设计,偏紧凑折叠,但未来可端到端整合。Baker 团队又一次证明:AI + 生物 = 无限可能!